Elasticsearch: что это, как работает и где применяется

 
Elasticsearch: как работает поисковый движок и где его применяют

Разбираем, как Elasticsearch индексирует и ищет данные, чем отличается от СУБД, где используется и что учесть при развертывании кластера.

Статья
Время на прочтение: 16 минут

Поиск по базе данных хорошо справляется с точным совпадением: найти запись по идентификатору, артикулу или адресу. Но пользователи вводят неполные фразы, ошибаются, меняют формы слов и ожидают получить наиболее подходящие результаты первыми. Похожая задача возникает при работе с миллионами логов и событий: данные нужно не только хранить, но и быстро исследовать.

Для этого используют Elasticsearch — специализированную поисковую систему и платформу аналитики. Разберем, как она превращает исходные данные в индекс, как поисковый запрос обрабатывается в распределенной среде, где полезна технология и почему ее обычно размещают рядом с основной базой данных, а не вместо нее.

Что такое Elasticsearch простыми словами

Elasticsearch — распределенный поисковый и аналитический движок на базе Apache Lucene. Он принимает данные в виде JSON-документов, заранее готовит их для поиска и предоставляет доступ через REST API. Такой поисковый движок быстро находит текст, оценивает соответствие, применяет фильтры и строит сводные показатели.

Данные можно разделить между несколькими узлами. Это позволяет обрабатывать обращения параллельно, увеличивать емкость добавлением серверов и сохранять работу при отказе части инфраструктуры. Однако распределенная система сама по себе не гарантирует скорость: кластер нужно рассчитывать под реальную нагрузку и большой объем данных.

Elasticsearch работает в режиме, близком к реальному времени. После записи документ становится доступен для поиска после refresh — операции, которая делает новые данные видимыми для поиска. Период задает index.refresh_interval: по умолчанию 1 секунда в Elastic Stack и 5 секунд в Elastic Cloud Serverless. Если интервал не задан явно, фоновый refresh выполняется для шардов с недавними поисковыми обращениями, поэтому это не гарантия видимости любой записи ровно через секунду. Для каталога, базы знаний или анализа логов это обычно приемлемо. Операции, которым нужна немедленная и строгая транзакционная согласованность, лучше оставлять основной СУБД.

Как в Elasticsearch устроены данные

Исходная запись попадает в поисковое хранилище. Elasticsearch анализирует поля документа, создает служебные структуры и распределяет данные по разделам. До загрузки важно определить, какие поля являются текстом, числами, датами, идентификаторами и признаками для фильтрации.

Документ, поле, индекс и маппинг

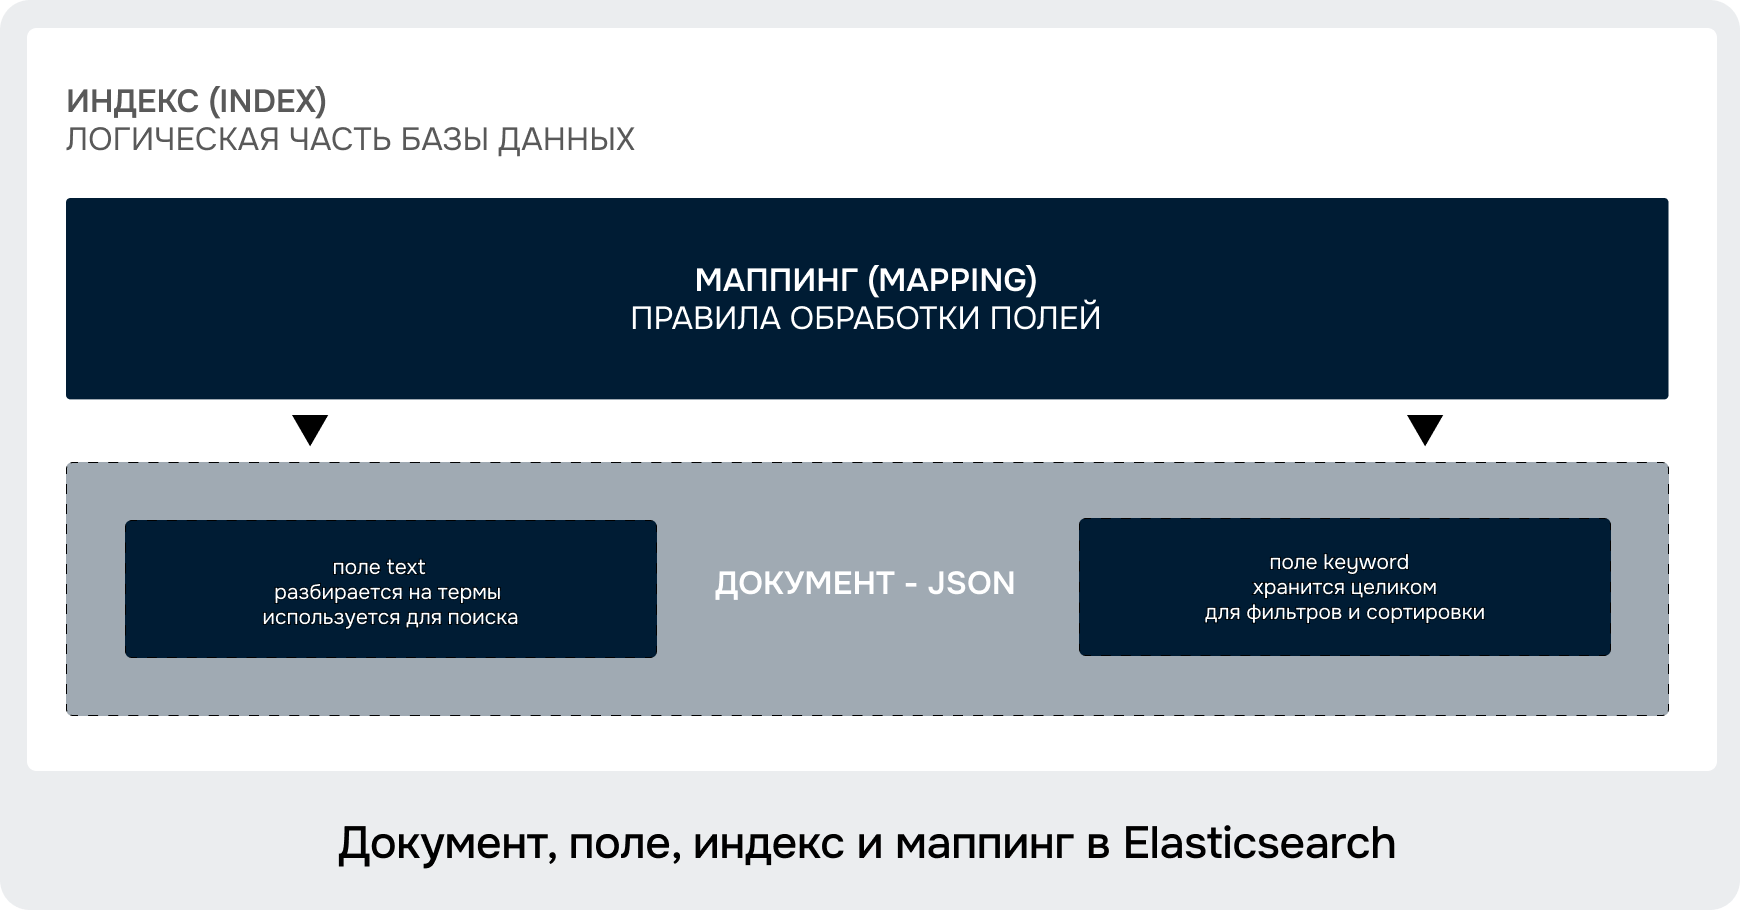
Документ — JSON-объект с набором полей. Карточка товара, например, может содержать название, описание, категорию, цену и артикул. Индекс объединяет документы со сходным назначением, а маппинг задает тип каждого поля и способ его обработки.

Поле text разбирается на термы и подходит для полнотекстового поиска. keyword хранит значение как единое целое и удобен для точных фильтров, сортировки и группировки. Одно название товара можно индексировать обоими способами: анализировать для поиска и сохранять точный вариант для агрегаций.

Например, название «Облачный сервер» хранят в поле name типа text для поиска по словам, а его подполе name.keyword типа keyword — для точного фильтра, сортировки и группировки по полному названию.

Ошибочный тип поля часто требует новой структуры и переиндексации документов. Приложение может обращаться через alias — постоянное логическое имя индекса. После подготовки нового индекса alias атомарно переключают на него, сохраняя доступность поиска. Изменения, поступившие во время переиндексации, нужно отдельно синхронизировать до переключения. Поэтому структура данных и правила преобразования — часть проектирования Elasticsearch, а не косметическая настройка.

Схема связей: документ, поле, индекс и маппинг

Узел, кластер, шард и реплика

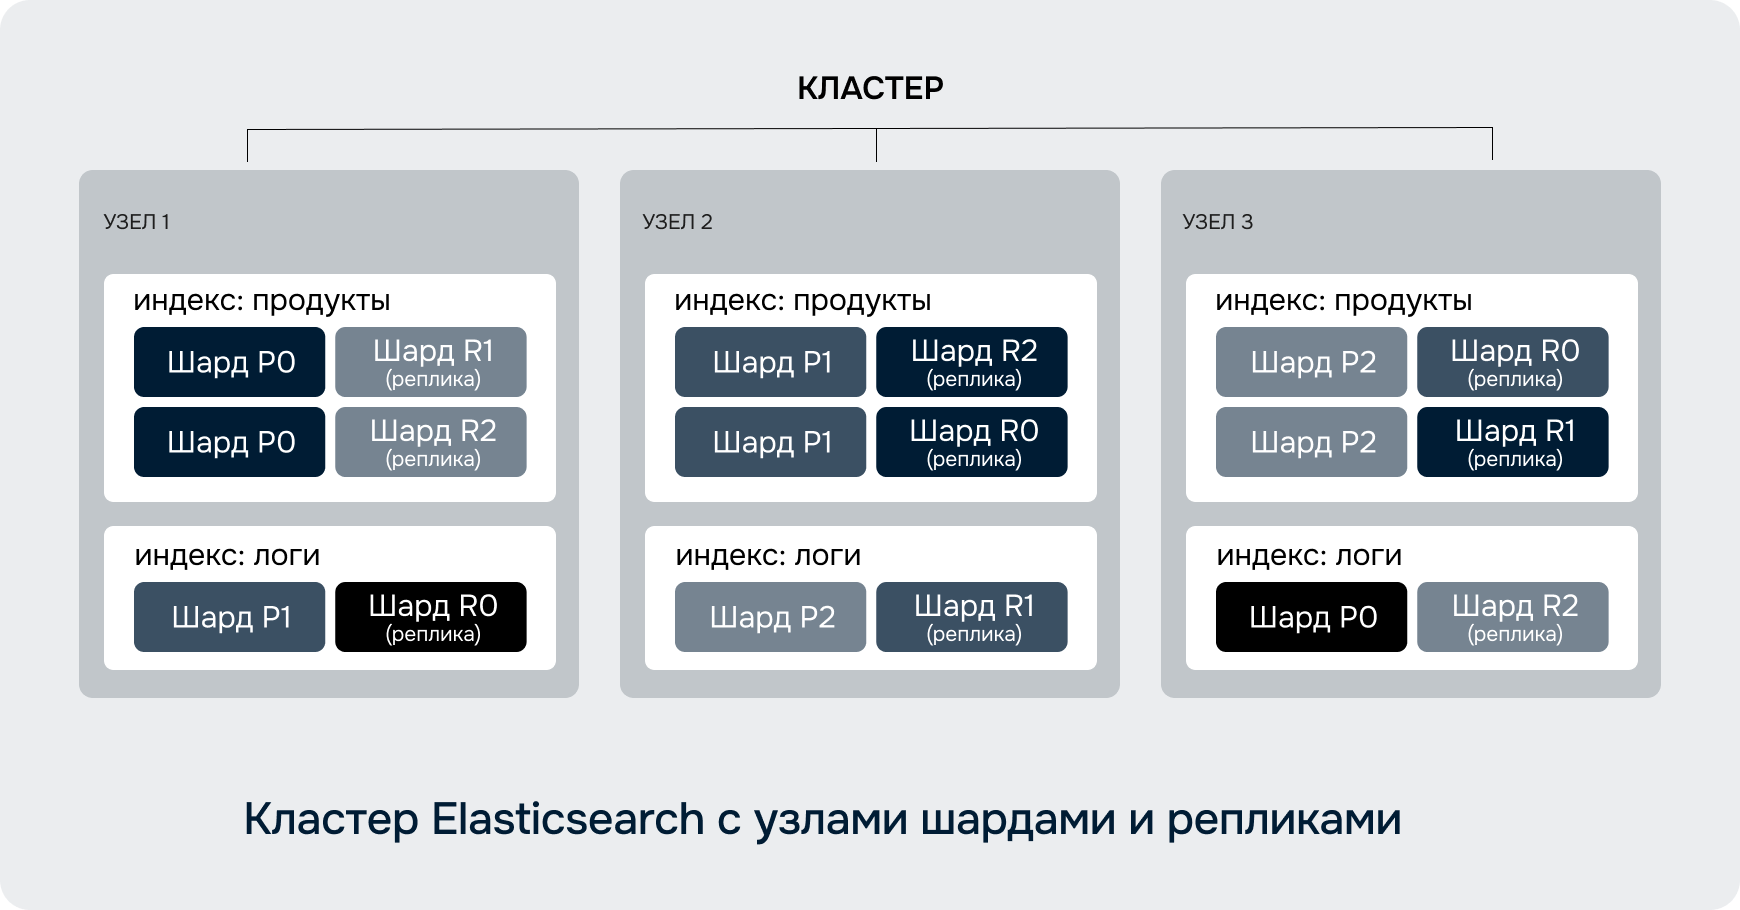
Узел — один запущенный экземпляр Elasticsearch. Несколько узлов образуют кластер. Для рабочего кластера, устойчивого к отказу одного узла, обычно используют не менее трех master-eligible узлов, как минимум два из которых могут стать master, а также не менее двух узлов с данными и реплики. В небольшом кластере эти роли совмещают. Каждый индекс делится на первичные шарды — самостоятельные части, которые можно размещать на разных узлах и обрабатывать параллельно.

Реплика — копия первичного шарда. Elasticsearch размещает ее на другом узле; если подходящего узла нет, реплика остается неназначенной. Она повышает доступность данных и может обслуживать чтение. Если первичный шард недоступен, одна из его реплик назначается первичной. Но это не заменяет резервное копирование: ошибочное удаление способно распространиться по кластеру.

Слишком грубое разделение ограничивает распределение нагрузки, а чрезмерная фрагментация расходует память и ресурсы на метаданные. Схему выбирают с учетом объема набора, темпа записи, обращений и возможностей серверов.

Число первичных шардов задают при создании индекса и напрямую изменить его нельзя: потребуется новый индекс через переиндексацию либо операции split или shrink с их ограничениями. Число реплик можно менять у существующего индекса. Для многих сценариев Elastic рекомендует начинать с размера шарда 10–50 ГБ и менее 200 млн документов на шард, затем проверять результат нагрузочными тестами. По умолчанию защитный лимит открытых обычных шардов в кластере равен 1000 × число non-frozen data nodes; он учитывает первичные шарды, реплики и неназначенные шарды. Это не рекомендация держать по 1000 шардов на каждом узле: безопасная нагрузка зависит от ресурсов и может быть существенно ниже.

Схема кластера с узлами, первичными шардами и репликами

Как Elasticsearch выполняет поиск

Система не просматривает все документы последовательно при каждом обращении. Основная работа выполняется заранее: во время индексирования текст превращается в термы, а Elasticsearch создает структуру, по которой быстро находит места их появления.

Анализ текста и токенизация

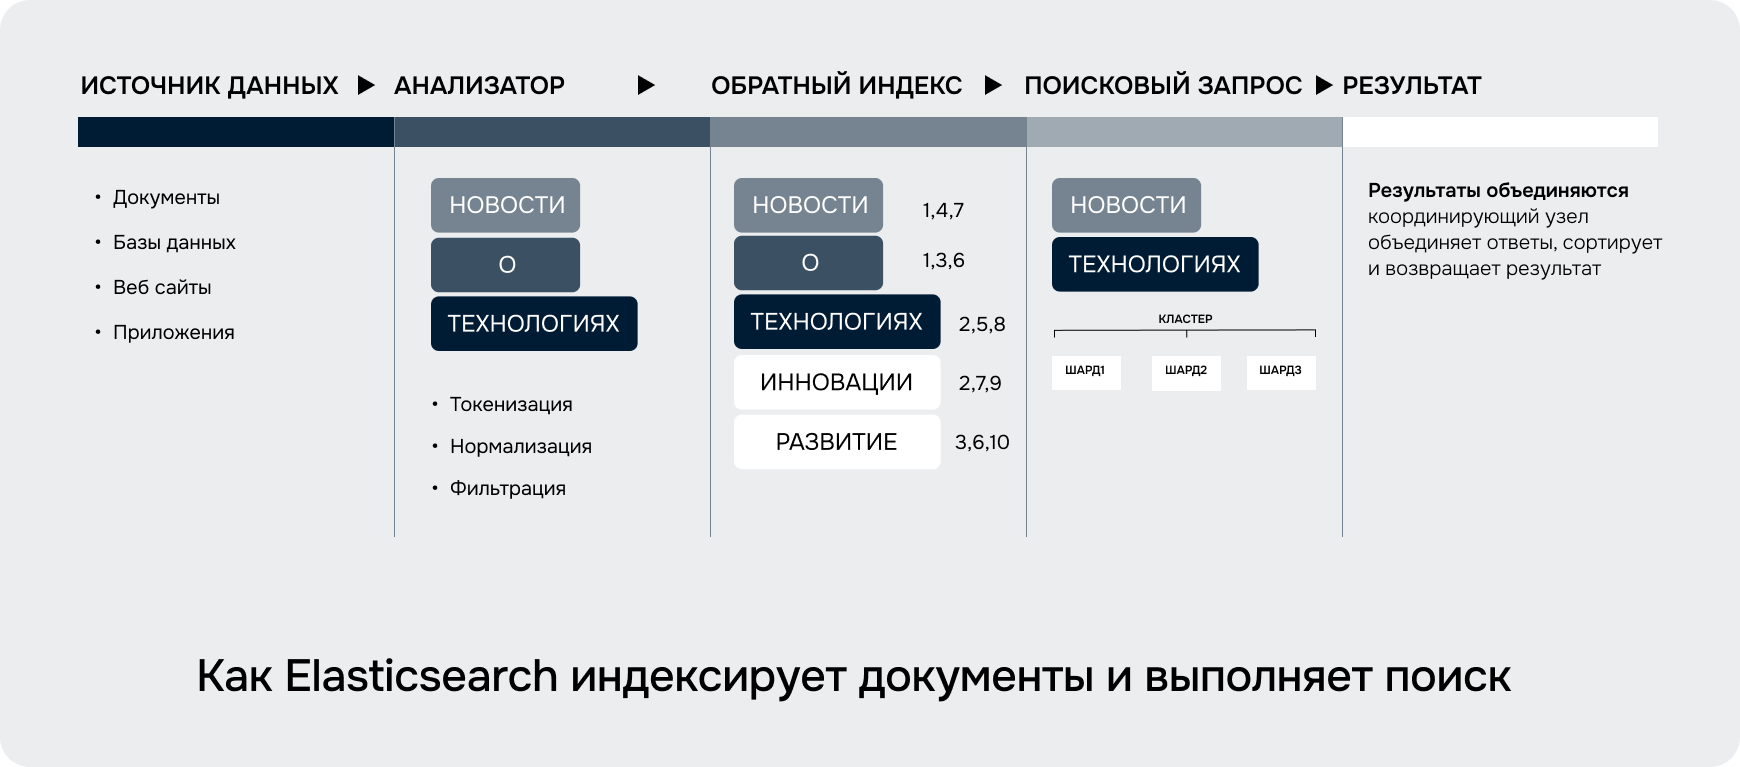
Анализатор последовательно обрабатывает строку. Токенизатор делит ее на элементы, а фильтры могут привести символы к нижнему регистру, удалить стоп-слова, нормализовать формы и применить синонимы. Цепочка зависит от языка, данных и задачи.

Фраза «Облачные серверы для бизнеса» после анализа превращается в набор токенов. Их конкретный вид зависит от анализатора: встроенный русский анализатор использует стемминг, а результат проверяют через `_analyze`. Ввод пользователя должен анализироваться совместимым способом, иначе одинаковые по смыслу слова окажутся разными для системы. Настройки проверяют на реальных фразах, особенно для русской морфологии, брендов и профессиональных терминов.

Обратный индекс и оценка релевантности

Обратный, или инвертированный, индекс связывает каждый термин со списком документов, в которых он встречается. Elasticsearch обращается к нужным спискам и объединяет результаты. Частота и позиции слов помогают оценить соответствие поисковой фразе.

По умолчанию для ранжирования применяется BM25. Алгоритм учитывает частоту термина в документе, его распространенность по коллекции и длину текста. Оценка _score помогает поставить наиболее подходящие результаты выше. На ранжирование влияют веса полей, синонимы и бизнес-правила. Фильтры ограничивают набор результатов, не влияя на _score.

Как запрос проходит по кластеру

Узел, принявший запрос, выполняет роль координирующего. Эта функция есть у каждого узла; в крупных кластерах для разгрузки можно выделить coordinating-only узлы. Он определяет нужные части индекса, направляет подзапросы, получает локальные ответы, объединяет и сортирует результаты. Работа выполняется параллельно.

Чем больше частей индекса участвует в обращении, тем выше расходы на координацию. Поэтому дополнительное дробление не всегда ускоряет поиск. Производительность проверяют на данных и сценариях, похожих на рабочие.

Схема: источник данных → анализатор → обратный индекс → поисковый запрос → результат

Основные возможности Elasticsearch

Полнотекстовый, семантический и гибридный поиск

Текстовый поиск сопоставляет запрос с термами обратного индекса и оценивает их соответствие. Для каталогов, статей и документов можно настроить язык, синонимы, опечатки, подсказки и веса полей.

Семантический поиск использует векторное представление содержания и находит близкие по смыслу документы без точного совпадения слов. Гибридный подход объединяет лексические и векторные сигналы. Он требует моделей, ресурсов и оценки качества; многим каталогам достаточно обычного поиска по тексту.

Фильтрация и агрегации

Фильтры отбирают документы по точным условиям: категории, цене, дате, статусу или региону. Обычно они не влияют на оценку релевантности. В каталоге можно сначала найти товары по описанию, а затем оставить нужный бренд и диапазон цены.

Аналитические расчеты показывают количество документов, средние значения и распределение по времени. На их основе строят фасеты и панели. Тяжелые вычисления нужно тестировать из-за нагрузки на память и процессор.

Масштабирование и отказоустойчивость

При росте нагрузки к кластеру добавляют серверы, после чего Elasticsearch автоматически распределяет и перемещает шарды с учетом правил размещения и доступных ресурсов. Дополнительные копии повышают способность обслуживать чтение.

Но масштабирование не исправляет неудачный маппинг, слишком широкие запросы, избыток мелких шардов или медленные диски. Изменения инфраструктуры должны опираться на задержки, загрузку процессора, память, диски и очереди.

Что входит в Elastic Stack

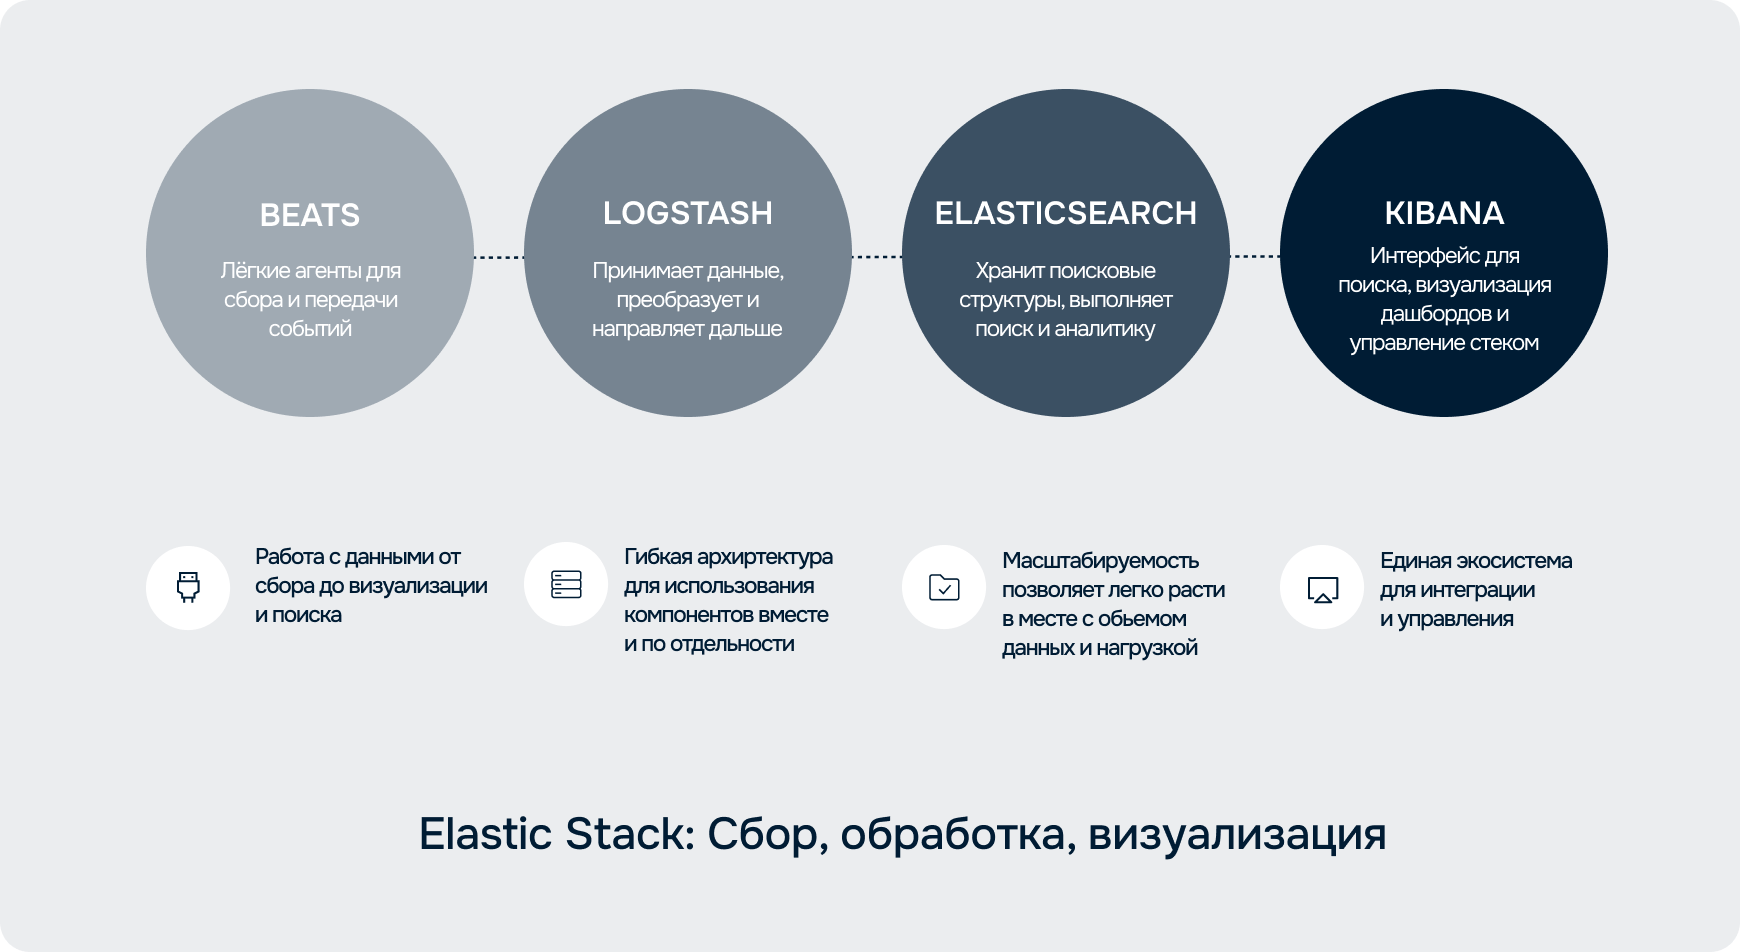
Elasticsearch хранит поисковые структуры, выполняет поиск и аналитику. Рядом с ним часто используют:

  • Logstash — принимает данные, преобразует их и направляет дальше;
  • Beats — легкие агенты для сбора и передачи событий;
  • Elastic Agent — единый агент для сбора логов, метрик и данных безопасности; Fleet в Kibana централизованно управляет агентами, политиками и интеграциями;
  • Kibana — интерфейс для поиска, визуализации, дашбордов и управления стеком.

Связку Elasticsearch, Logstash и Kibana называют ELK Stack, или ELK-стек. После появления Beats распространилось название Elastic Stack. Компоненты не обязательны все сразу: данные может передавать собственный сервис, а приложение — обращаться напрямую к REST API Elasticsearch без Kibana.

Схема ролей Elasticsearch, Logstash, Beats и Kibana

Где применяют Elasticsearch

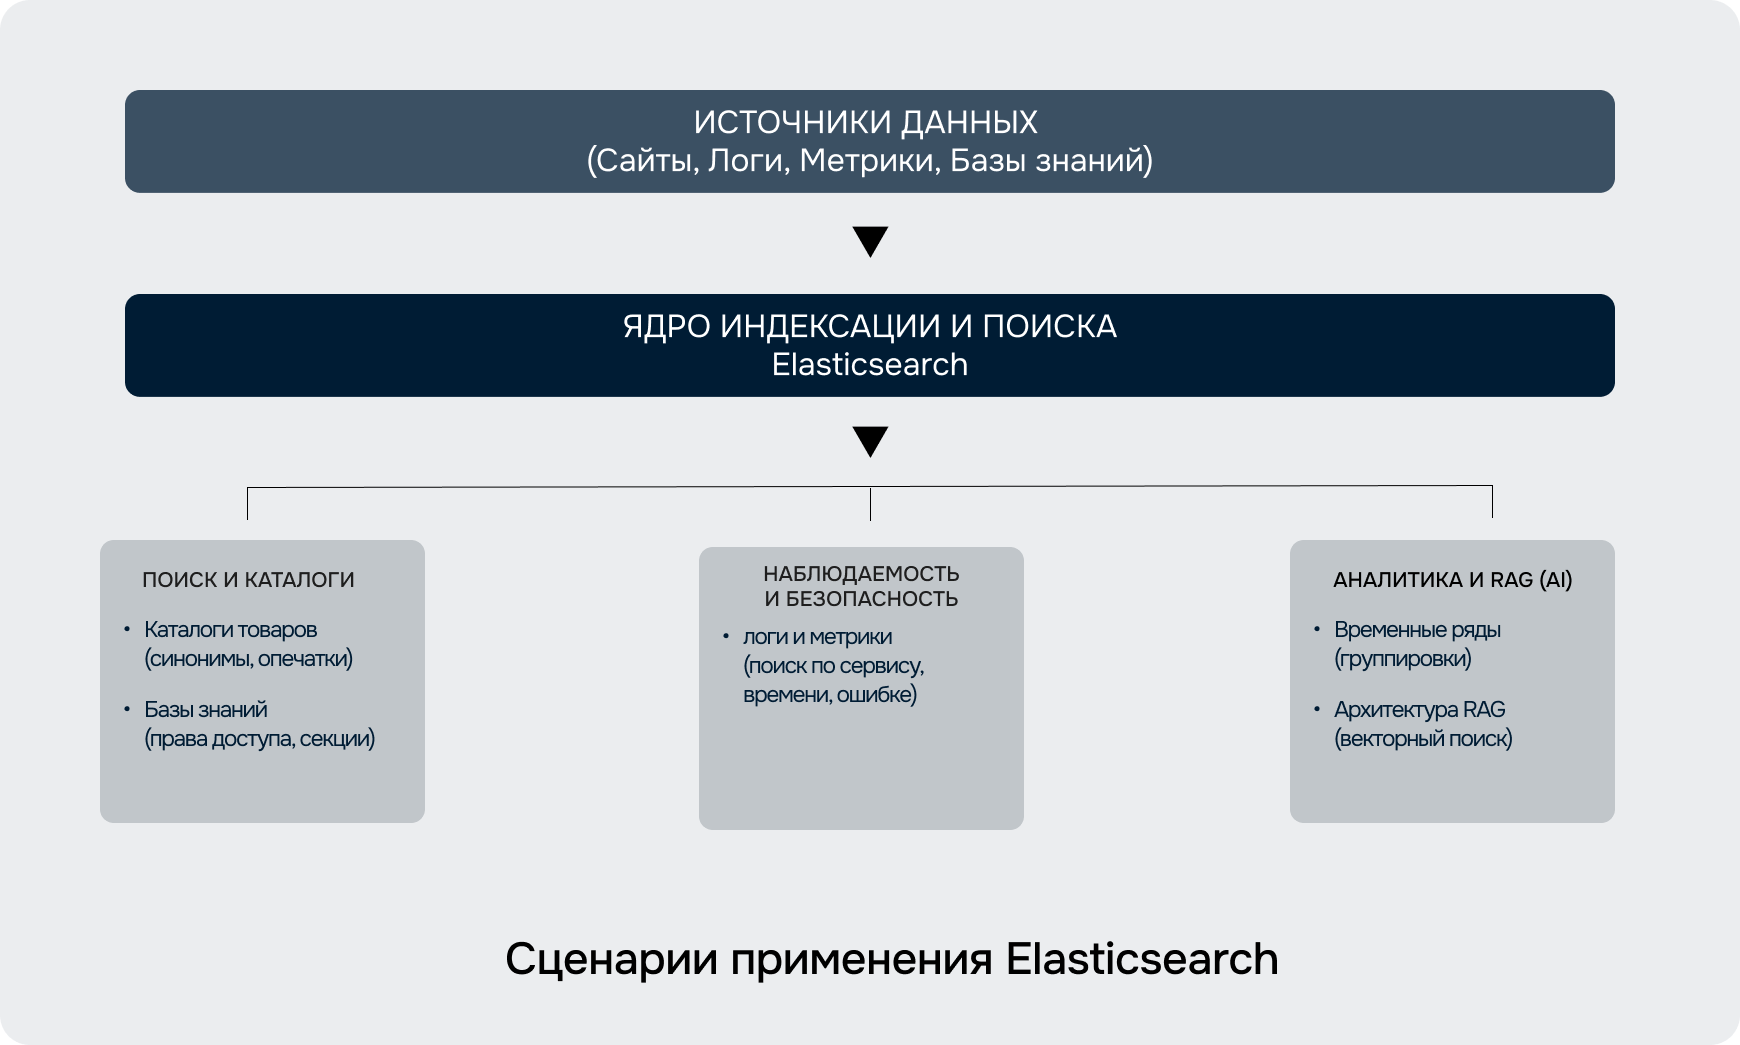
Поиск по сайтам, каталогам и корпоративным знаниям

В каталоге Elasticsearch ищет по названию и описанию, учитывает опечатки и синонимы, предлагает подсказки и фильтрует товары. Веса полей и дополнительные признаки помогают управлять порядком результатов, не ухудшая качество выдачи.

В базе знаний тот же подход применяют к инструкциям, договорам, обращениям и внутренним документам. Их разделяют по подразделению, уровню доступа, типу и дате. Права необходимо проверять при каждом запросе: наличие материала в индексе не делает его доступным любому пользователю.

Анализ логов, наблюдаемость и безопасность

Приложения, операционные системы и сетевые устройства создают поток событий. Анализ состояния системы по логам, метрикам и трассировкам называют наблюдаемостью (observability). После централизованного сбора Elasticsearch помогает найти сообщения по времени, сервису, ошибке или идентификатору, а интерфейс визуализации — показать динамику на панелях.

В информационной безопасности поиск помогает исследовать связанные события. Но Elasticsearch не создает журналы сам: нужны источники, агенты, транспорт, нормализация и политика хранения. В SIEM (системе управления событиями информационной безопасности) такие данные используют для корреляции событий, обнаружения угроз и расследования инцидентов.

Аналитика, временные ряды и RAG

Elasticsearch применяют для анализа событий, метрик и временных рядов. Группировки позволяют перейти от общего графика к сервису, периоду или признаку. При длительном хранении важно управлять жизненным циклом индексов и переносить менее востребованные данные на подходящие уровни.

При RAG (retrieval-augmented generation) Elasticsearch находит релевантные фрагменты документов, а приложение передает их языковой модели для подготовки ответа. Используют лексический, векторный или гибридный поиск. Качество зависит также от разбиения материалов, метаданных и фильтрации доступа.

Инфографика: поиск в каталоге, анализ логов, аналитика и RAG

Elasticsearch и реляционная база данных

Elasticsearch хранит и возвращает документы, поэтому его иногда называют базой данных. Но его основная роль — поисково-аналитическая. Реляционная СУБД поддерживает транзакции, связи и целостность операционных данных.

Критерий Elasticsearch Реляционная СУБД
Модель JSON-документы и индексы Таблицы, строки, связи
Главная задача Поиск, ранжирование, фильтры, аналитика Транзакции и согласованное хранение
Транзакции Не рассчитан на сложные многообъектные транзакции Поддерживает ACID и ограничения целостности
Полнотекстовый поиск Одна из основных специализаций Возможности зависят от конкретной СУБД
Масштабирование Распределение частей индекса Зависит от СУБД и архитектуры
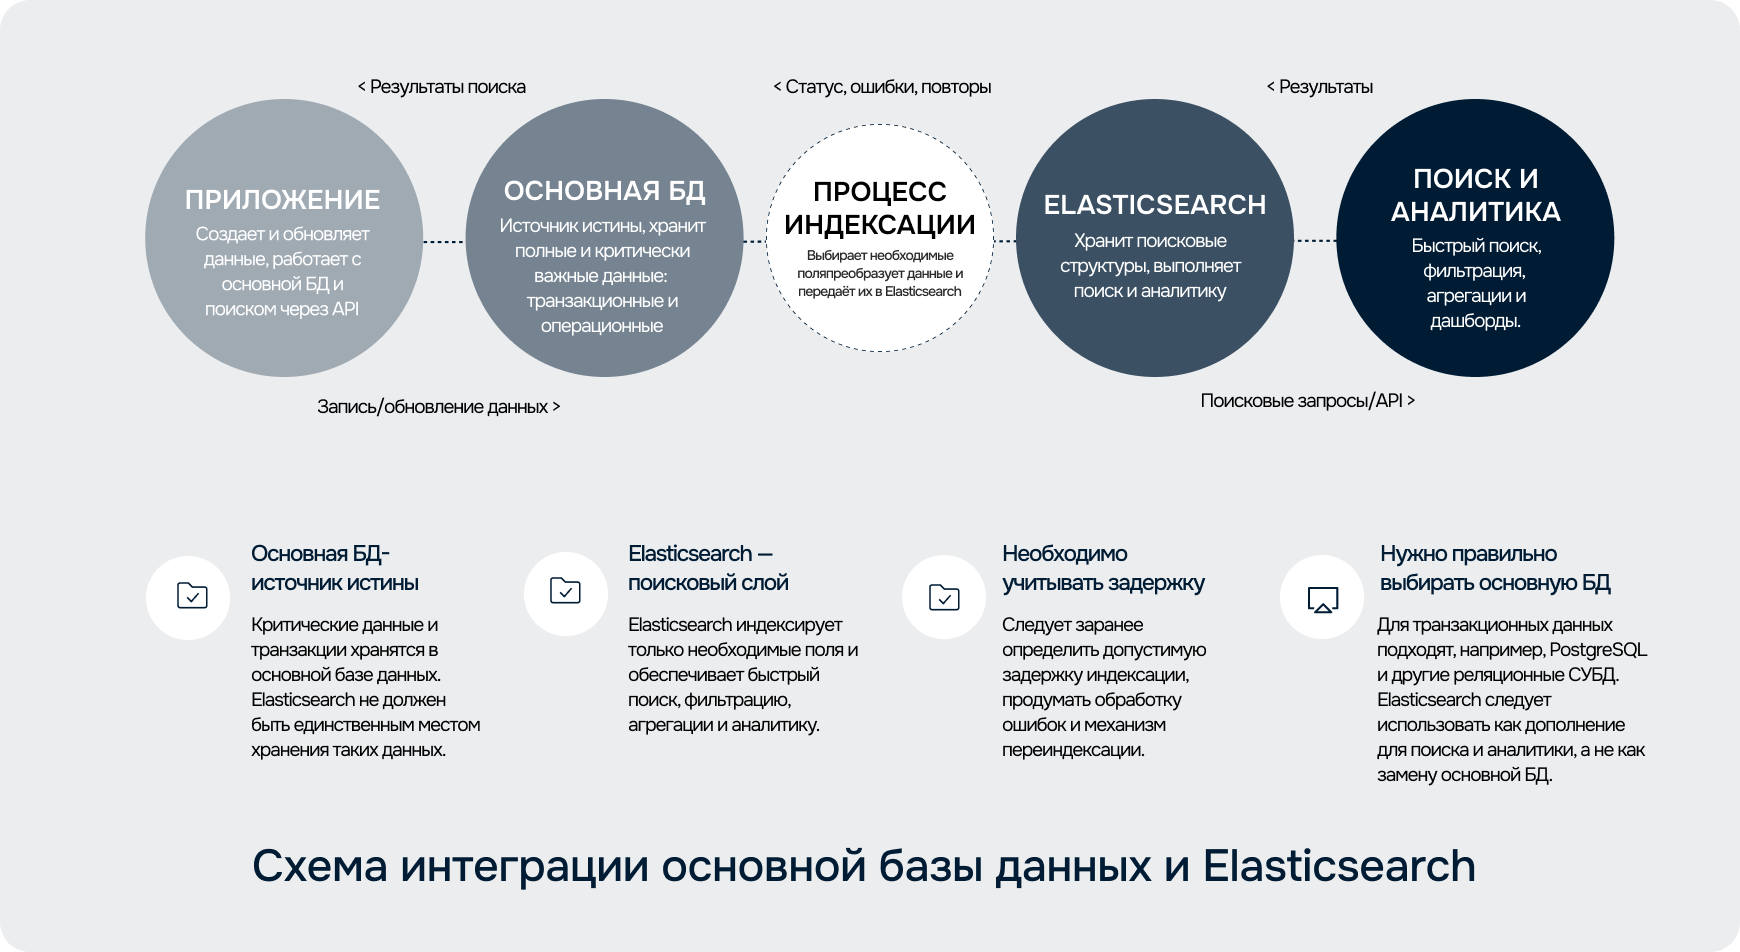
Типичная роль Поисковый или аналитический слой Основной источник истины


Частая схема: приложение записывает данные в основную БД, а отдельный процесс передает нужные поля в Elasticsearch. Поиск идет по индексу, но критические изменения подтверждаются по источнику истины. Заранее определяют допустимую задержку, обработку ошибок и переиндексацию.

Для транзакционных данных подойдут, например, облачные базы данных PostgreSQL, а Elasticsearch подключают, когда требований к поиску и аналитике больше, чем удобно закрывать средствами основной системы.

Схема: основная БД как источник истины + Elasticsearch как поисковый слой

Преимущества и ограничения

Сильные стороны Elasticsearch — быстрый поиск по тексту, управление порядком выдачи, фильтры, аналитические расчеты и распределенная архитектура. Одна система может поддерживать каталог, исследование логов и аналитику, если модель данных и ресурсы рассчитаны под нагрузку.

За это приходится платить сложностью эксплуатации. Кластеру нужны память, быстрые диски, мониторинг и компетенции команды. Ошибка в схеме полей приводит к лишнему объему или неверной выдаче, а чрезмерная фрагментация расходует ресурсы. Синхронизация с основной системой требует отдельного надежного процесса.

Реплики защищают от отказа сервера, но не от ошибочного удаления или повреждения данных. Нужны резервные снимки данных (snapshots): Elasticsearch создает их в отдельном от кластера репозитории, а восстановление регулярно проверяют.

Когда Elasticsearch нужен, а когда можно обойтись без него

Внедрение оправдано, если нужен поиск по большому количеству текстов и полей, ранжирование, подсказки, фильтры и группировки, а объем или нагрузка превышают возможности текущего решения. Дополнительные сценарии — централизованный анализ логов и поиск по корпоративным знаниям.

Если данных немного, поиск идет по нескольким точным полям, а нагрузка умеренная, возможностей существующей базы может хватить. Полнотекстовый поиск PostgreSQL закрывает многие задачи без отдельного кластера. Сначала стоит проверить простое решение по качеству и скорости, затем сравнить с измеримыми требованиями.

Не выбирайте Elasticsearch только «на вырост». Нужно знать требуемую задержку, объем документов, характер запросов и критерий качества выдачи. Без этого новая система добавит сложность раньше, чем принесет пользу.

Варианты развертывания

Elasticsearch разворачивают на собственной инфраструктуре, виртуальных машинах в облаке или используют как управляемый сервис. В первом случае команда полностью контролирует среду, но отвечает за отказоустойчивость, обновления и расширение ресурсов.

Облачные серверы позволяют быстрее менять конфигурации и добавлять узлы, сохраняя контроль над настройками. Ответственность за ОС, Elasticsearch, безопасность и мониторинг остается у команды. Управляемый сервис сокращает рутину, но требует оценки версий, функций, ограничений, размещения данных и стоимости.

Доступность Elastic в России

С 2022 года Elastic прекратила продажи компаниям в России. Действуют экспортные ограничения, затрагивающие в том числе официальные загрузки. Для российского проекта заранее проверяют доступность дистрибутивов, обновлений и коммерческих сервисов.

Выбор зависит от допустимого простоя, компетенций, требований и нагрузки. В стоимость входят не только серверы, но и обновления, резервирование, мониторинг и работа специалистов.

Что учесть при проектировании кластера

Расчет начинают с объема входящих данных, размера документа, срока хранения, типов запросов и допустимого времени ответа. Пики индексирования и поиска могут совпадать.

Для серверов важны память, процессор, быстрые SSD для интенсивной нагрузки, сеть и запас места. Разделение индекса проверяют экспериментально, а копии распределяют так, чтобы отказ узла или зоны не уничтожил все данные.

До запуска проводят тесты на рабочих профилях данных. Контролируют состояние Elasticsearch, рост индексов, задержки, очереди, диски и нераспределенные части.

Безопасность и эксплуатация

Кластер не следует публиковать в интернете без необходимости. Доступ ограничивают сетевым контуром, соединения защищают TLS. Пользователи и сервисы проходят аутентификацию и получают минимальные роли. Пароли, сертификаты и API-ключи нельзя хранить в коде или открытых конфигурациях.

Резервное копирование строят на snapshots — снимках индексов и, при необходимости, состояния кластера. Их сохраняют в отдельном от кластера репозитории, обычно в объектном хранилище. Для S3-совместимого репозитория можно рассмотреть объектное хранилище S3 Nubes; совместимость с выбранной версией Elasticsearch и восстановление нужно проверить. Snapshot Lifecycle Management (SLM) автоматизирует создание снимков по расписанию и их удаление по правилам хранения. Политику связывают с RPO — допустимым периодом потери данных — и RTO — целевым временем восстановления. Восстановление регулярно проверяют в изолированной среде. Резервное копирование и аварийное восстановление нужно проектировать как единый процесс, а не ограничивать созданием копий. При большом объеме копирования медленные диски увеличивают задержки и время восстановления. Для узлов с интенсивной записью, поиском и восстановлением предпочтительны быстрые SSD; дисковую нагрузку от snapshots и восстановления проверяют на тестах.

Эксплуатация включает обновления, контроль совместимости, жизненный цикл индексов и мониторинг. Важны задержки, ошибки индексирования, heap-память (область памяти JVM для рабочих объектов Elasticsearch), диски, темп роста и длительность восстановления. Каждое предупреждение должно вести к понятному действию.

Краткий чек-лист перед внедрением

  1. Какую проблему поиска или аналитики должна решить система?
  2. Каковы текущий и прогнозируемый объем, число полей и темп записи?
  3. Какие поисковые сценарии, фильтры, группировки и требования к качеству выдачи обязательны?
  4. Какая система остается источником истины и как обновляется индекс?
  5. Какая задержка появления изменений допустима?
  6. Какие RPO и RTO установлены и где хранятся snapshots?
  7. Кто отвечает за безопасность, обновления, мониторинг и инциденты?
  8. Что показал тест на данных и запросах, близких к рабочим?
  9. Как будет контролироваться стоимость при росте объема и числа копий?

Если ответов нет, начните с ограниченного пилота. Он должен проверить релевантность, задержки, потребление ресурсов и операционную модель, а не просто подтвердить, что поиск запускается.

Частые вопросы

Elasticsearch — это база данных?

Он хранит JSON-документы, но оптимизирован прежде всего под поиск и аналитику. Для транзакций, сложных связей и строгой целостности обычно используют основную СУБД.

Может ли Elasticsearch заменить PostgreSQL или MySQL?

Это возможно в отдельных системах, но не является универсальной архитектурой. Чаще СУБД остается источником истины, а Elasticsearch получает данные для поиска и аналитики.

Обязательно ли устанавливать Kibana?

Нет. Приложение может обращаться напрямую к REST API Elasticsearch без Kibana, а визуализацию можно строить другими средствами. Kibana удобна для исследования данных и управления стеком, но ее необходимость зависит от задач команды.

Чем Elasticsearch отличается от OpenSearch?

OpenSearch возник как форк Elasticsearch 7.10.2 и развивается независимо. Базовые возможности поиска и аналитики схожи, но API современных версий, плагины и клиенты различаются. OpenSearch распространяется под Apache 2.0, а условия Elasticsearch зависят от дистрибутива и исходного кода. Совместимость проверяют по требованиям проекта.

Можно ли использовать Elasticsearch бесплатно?

Часть функций доступна бесплатно, но условия зависят от дистрибутива, версии и модели использования. После изменений 2024 года бесплатные части исходного кода доступны по AGPLv3, SSPL и Elastic License 2.0, а готовые релизы Elastic продолжают выходить под Elastic License. Актуальные условия нужно проверить для своей схемы.

Вывод

Elasticsearch полезен, когда проекту требуется качественный полнотекстовый поиск, гибкая аналитика или обработка большого потока событий. В основе этих преимуществ — заранее подготовленная структура, распределение данных и управление порядком результатов.

Но Elasticsearch добавляет отдельный инфраструктурный контур: схему полей, синхронизацию, безопасность, snapshots, мониторинг и обновления. Решение следует принимать по измеримым требованиям и тестам, а не по популярности технологии.

Для подбора облачной инфраструктуры под Elasticsearch можно обсудить с командой Nubes требования к ресурсам, нагрузке и доступности.